Sequences
picea represents a single biological sequence as a Sequence, and groups of sequences as a
SequenceCollection (unaligned) or a MultipleSequenceAlignment (aligned).
import numpy as np
from matplotlib import pyplot as plt

from picea import MultipleSequenceAlignment, Sequence, SequenceCollection
Single sequences
A sequence has a header and a sequence string. When no alphabet is given, picea picks the best matching one (DNA or amino acid).
dna = Sequence("my_gene", "ATGGCTAGCAAAGGAGAAGAACTTTTCACTGGATAA")
dna
Sequence(header='my_gene', alphabet=Alphabet(name='DNA', members='-?acgtnACGNT'))
dna.alphabet.name, len(dna)
('DNA', 36)
Sequence("peptide", "MKVLAAGIVGLL").alphabet.name
'AminoAcid'
Transformations return new sequence objects, so they can be chained.
dna.reverse_complement.sequence
'TTATCCAGTGAAAAGTTCTTCTCCTTTGCTAGCCAT'
dna.amino_acids.sequence
'MASKGEELFTG*'
dna[:12].lowercase.sequence
'atggctagcaaa'
print(dna.to_fasta(linewidth=20))
>my_gene
ATGGCTAGCAAAGGAGAAGA
ACTTTTCACTGGATAA
Sequence collections
Collections are read from and written to fasta or json. This file contains protein sequences of hydroxycinnamoyl transferase (HCT) homologs from several plant species.
seqs = SequenceCollection.from_fasta(filename="data/HCT.fasta")
len(seqs), seqs.headers[:3]
(41, ['Glyma.08G220200.1', 'Medtr4g007540.1', 'Eucgr.F03978.1'])
Index by header to get a Sequence, iterate to get all of them, or use iloc to select a subset by
position.
seqs["AT5G48930.1"].sequence[:60]
'MKINIRDSTMVRPATETPITNLWNSNVDLVIPRFHTPSVYFYRPTGASNFFDPQVMKEAL'
lengths = [len(seq) for seq in seqs]
min(lengths), max(lengths)
(312, 497)
subset = seqs.iloc[:3]
print(subset.to_fasta(linewidth=60))
>Glyma.08G220200.1
MMINVKESTMVRPAEEVARRVVWNSNVDLVVPNFHTPSVYFYRSNGAPNFFDGKVMKEAL
TKVLVPFYPMAGRLLRDDDGRVEIDCDGQGVLFVEADTGAVIDDFGDFAPTLELRQLIPA
VDYSQGIASYPLLVLQVTHFKCGGVSLGVGMQHHVADGASGLHFINTWSDVARGLDVSIP
PFIDRTILRARDPPRPIFDHIEYKPPPAMKTQQATNASAAVSIFRLTRDQLNTLKAKSKE
DGNTISYSSYEMLAGHVWRSVSKARALPDDQETKLYIATDGRSRLQPPTPPGYFGNVIFT
TTPIAVAGDLMSKPTWYAASRIHNALLRMDNDYLRSALDYLELQPDLKALVRGAHTFKCP
NLGITSWTRLPIHDADFGWGRPIFMGPGGIAYEGLSFIIPSSTNDGSLSVAIALQPDHMK
LFKDFLYDI
>Medtr4g007540.1
MIINVRDSTMVRPSEEVTQRTVWNSNVDLVVPNFHTPSVYFYRPNGASNFFDAKVLKEAL
SKVLVPFYPMAGRLRRDEDGRVEIDCDGQGVLFVEADTGGVVDDFGDFAPTLELRQLIPA
VDYSRGIETYPLLVLQVTYFKCGGVSLGVGMQHHVADGASGLHFINTWSDVARGLDVSMP
PFIDRTLLRARDPPRPVFDHIEYKPPPSMKTHQQPTKPGSDGAAVSIFKLTREQLNTLKA
KSKEAGNTIHYSSYEMLAGHVWRSVCKARSLPDDQETKLYIATDGRARLQPPPPPGYFGN
VIFTTTPIAIAGDLMTKPTWYAASRIHNALSRMDNEYLRSALDFLELQPDLKALVRGAHT
FKCPNLGITSWARLPIHDADFGWGRPIFMGPGGIAYEGLSFIIPSSANDGSLSVAIALQH
EHMKVFKDFLYDI
>Eucgr.F03978.1
MISTFSRMIINVKGSTVVCPAEDTPRCTLWNANVDLVVPSMHTPSVYFYRPTGSDDFFDS
RVLKEALSRALVLFYPMAGRLKRDEDGRIEIDCNAEGVLFVEAETSSVINDFGDFAPTLE
LRKLIPAVDYSGGISSYPVLVLQVTYFKCGGVSLGVGMQHHVADGFSGLHFVNTWSDLAR
GLDVKLPPFIDRTLLRAHSPPRPQFPHIEYQSPPALRVSPETTNSAPYSTTVSIFKVTRE
QLDTLKTQAELENGNITSYSSYEILAGHVWRCACRARGLSDDQDSKLYIATDGRMRLSPP
LPRGYFGNVIFTATPIAVAGDLISKPVSYAAQKIRESLARMDDDYLRSALDYLELQPDLS
ALVRGAHTFRCPNLGITSWVRLPIHDADFGWGRPIFMGPGGIAYEGLSFILPSSTSDGSL
SVAISLQTEHMKLFEKFLYDFPGESPRKRCKLDD
Headers and sequences can be modified in place.
subset.rename_inplace(lambda header: header.split(".")[0])
subset.headers
['Glyma', 'Medtr4g007540', 'Eucgr']
subset.add(Sequence("my_protein", "MASKGEELFTG"))
subset.headers
['Glyma', 'Medtr4g007540', 'Eucgr', 'my_protein']
print(subset.to_json(indent=2)[:200])
[
  {
    "header": "Glyma",
    "sequence": "MMINVKESTMVRPAEEVARRVVWNSNVDLVVPNFHTPSVYFYRSNGAPNFFDGKVMKEALTKVLVPFYPMAGRLLRDDDGRVEIDCDGQGVLFVEADTGAVIDDFGDFAPTLELRQLIPAVDYSQGIASYPLLVLQVTHFKCGGVSLGVGMQHH
Multiple sequence alignments
A MultipleSequenceAlignment stores sequences of equal length (gaps are -).
msa = MultipleSequenceAlignment.from_fasta(filename="data/multiple_sequence_alignment.fasta")
msa.n_seqs, msa.n_chars
(41, 577)
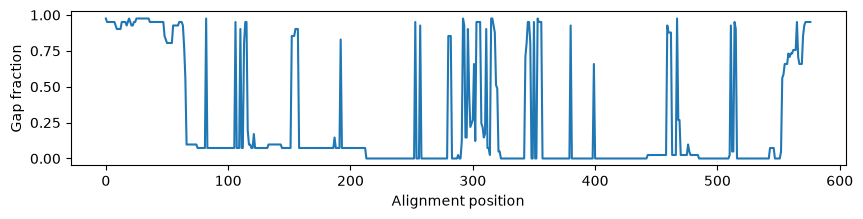
Alignment columns are easy to analyse with numpy, for example the fraction of gaps per alignment position.
columns = np.array([list(sequence) for sequence in msa.sequences])
gap_fraction = (columns == "-").mean(axis=0)

fig, ax = plt.subplots(figsize=(10, 2))
ax.plot(gap_fraction)
ax.set_xlabel("Alignment position")
ax.set_ylabel("Gap fraction");
Unaligned collections can be aligned with an external aligner that reads fasta from stdin, such as MAFFT (not run here):
msa = seqs.align(method="mafft")